Note
Go에서는 Goroutine 경량 스레드를 구현해서 OS 스레드를 이용하는 대부분의 프로그래밍 언어들보다 더 효율적으로 스레드를 이용할 수 있어서 이에 대해서 알아보겠습니다.
고루틴이란?
고루틴은 Go에서 구현하고 사용하는 경량 스레드 모델로 OS 스레드보다 훨씬 가벼워 수천, 수만 개의 고루틴을 동시에 실행할 수 있습니다.(초기 스택 크기는 약 2KB)
고루틴의 런타임 시스템 아키텍처
앞서 본 고루틴의 특징들이 존재하는 가장 큰 이유는 고루틴의 런타임 시스템 아키텍처 덕분입니다. 고루틴은 아래 그림과 같이 (물리 코어) - (OS 스레드) - (고루틴)과 같은 아키텍처를 가집니다.
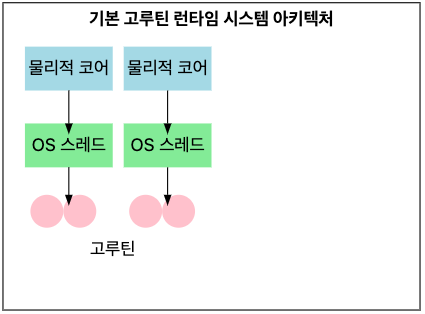
OS 스레드의 최대 개수는 GOMAXPROCS go env 값으로 조절할 수 있지만 default는 cpu 코어 개수로 설정됩니다.
고루틴이 GOMAXPROCS 개수를 넘어가면 아래 그림과 같이 대기 상태로 고루틴들이 머무르게 됩니다.
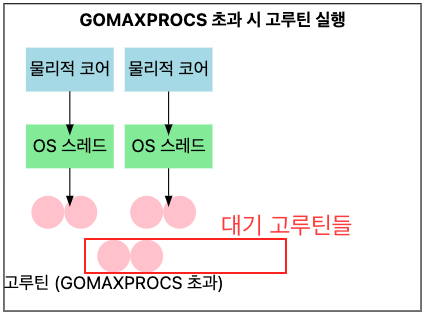
이러한 상태에서 할당되어 실행중인 고루틴에서 시스템 콜(네트워크 request, I/O 작업 등) 작업들이 수행되면 해당 고루틴을 대기 상태로 바꾸고 대기 상태의 다른 고루틴을 OS 스레드에 할당합니다.
그렇다면 왜 고루틴이 OS 스레드보다 효율적일까요? 이를 위해서 먼저 OS 스레드가 상대적으로 무겁고 느린 이유를 살펴보겠습니다.
OS 스레드 단점
- 스택 메모리 크기
- OS 스레드는 스택 메모리 크기가 1-8MB로 초기부터 크게 고정되어 있습니다.
- 공유 자원
- OS 스레드는 스택을 공유하지 않습니다. 이로 인해, 스레드마다 스택 메모리가 존재해야해서 메모리 사용량이 커지고 컨텍스트 스위칭 마다 캐시를 비워서 메인 메모리에 접근해야 합니다. (L1 접근 시간: 0.5 - 1 ns, L2 접근 시간: 3 - 10 ns, L3 접근 시간: 10 - 20 ns, RAM: 50 - 100 ns)
- 커널 모드 사용
- OS 스레드를 생성할 때는 커널 호출이 필요하고 이는 많은 시간이 소요됩니다.
런타임 시스템 아키텍처로 OS 스레드의 단점을 최소화
위와 같은 OS 스레드의 단점을 고루틴 런타임 시스템 아키텍처 이용 시 최소화 할 수 있습니다.
- 동적인 스택 메모리 크기
- 초기에 2KB로 작은 크기의 스택을 생성하고 동적으로 크기 증가 및 감소가 가능합니다.
- M:N 스케줄링 모델
- OS 스레드를 소수의 N개, 고루틴을 다수의 M개로 매핑해서 OS 스레드 간 컨텍스트 스위칭 발생 자체를 줄여 캐시 활용을 최적화합니다.
- 사용자 공간 스케줄링
- OS 스레드를 그대로 이용하지 않고 고루틴을 사용자 공간에서 사용함으로써 메모리를 공유해 컨텍스트 스위칭 감소가 가능합니다.
결국 위와 같은 것들이 가능한 이유는 OS 스레드를 그대로 사용하지 않고 Go 런타임에서 고루틴을 만들어 OS 스레드와 매핑시키는 시스템 아키텍처 덕분입니다.
(TMI, 학습 남기기 위함) 컨텍스트 스위칭에서 병목이 가장 큰 작업
컨텍스트 스위칭에서 병목이 가능 큰 작업은 크게 2가지로 CPU 캐시 초기화, TLB 재로드입니다. 이 2개는 모두 캐시와 관련된 작업이고 이로 인해서 메인 메모리에 접근하게 되면서 병목이 크게 발생합니다.
- CPU 캐시 초기화
- 컨텍스트 스위칭을 하면서 커널에서는 스레드의 캐시를 초기화하고 다른 스레드를 받습니다. 그러니까 다른 스레드를 처음 실행 시에는 캐시가 없어서 메인 메모리에 접근해야합니다. 이런 이유로 메인 메모리 접근 횟수가 크게 많아져 큰 병목을 유발합니다.
- TLB 재로드
- TLB라는 가상 주소를 물리적 주소로 빠르게 변환하기 위한 테이블 구조의 캐시입니다. CPU에서 데이터를 가져오기 위해서 page table로 접근해서 가상 메모리 주소를 실제 메모리 주소로 변환하는데 page table이 메인 메모리에 존재해 2번이나 메인 메모리에 접근해야합니다(page table 접근, 가져온 실제 메모리 주소로 접근). 이런 메모리 접근을 줄이기 위한 캐시가 TLB고 먼저 TLB를 탐색해보고 없으면 페이지 테이블로 접근하고 존재하면 해당 프레임 넘버로 접근하는 방식입니다.
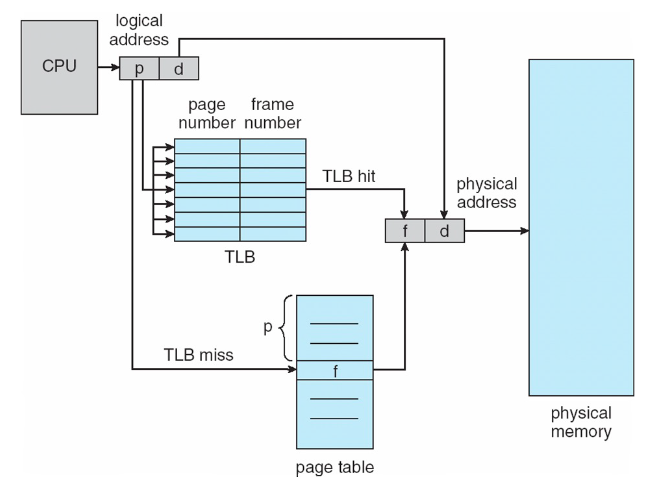
- 컨텍스트 스위칭 이런 TLB 재로드가 필요한 이유는 각 프로세스가 페이지 테이블을 따로 메인 메모리에 저장해서 같은 가상 메모리 주소가 다른 실제 메모리를 가르키고 있을 수 있습니다.
- 같은 프로세스에서 같은 페이지 테이블을 사용한다면 스레드 간 컨텍스트 스위칭에서는 발생하지 않겠네요? -> 멀티코어 환경에서 스레드가 다른 코어로 이동하면 이동한 코어의 TLB에서 관련 페이지가 무효화되고 다시 로드됩니다.
- 이렇게 재로드 되면 캐시와 마찬가지로 초기에 hit 보다 miss가 많아지고 재로드 과정에서도 병목이 발생합니다.
- TLB라는 가상 주소를 물리적 주소로 빠르게 변환하기 위한 테이블 구조의 캐시입니다. CPU에서 데이터를 가져오기 위해서 page table로 접근해서 가상 메모리 주소를 실제 메모리 주소로 변환하는데 page table이 메인 메모리에 존재해 2번이나 메인 메모리에 접근해야합니다(page table 접근, 가져온 실제 메모리 주소로 접근). 이런 메모리 접근을 줄이기 위한 캐시가 TLB고 먼저 TLB를 탐색해보고 없으면 페이지 테이블로 접근하고 존재하면 해당 프레임 넘버로 접근하는 방식입니다.
마무리
reference에 책을 읽고 추가적으로 궁금한 부분들에 대해서 더 적어봤고 고루틴이 왜 더 효율적이고 가볍다고 표현하는지 이해할 수 있었습니다. 마지막으로 잘못된 지식이 있다면 comment 부탁드립니다.