Note
해당 포스팅에서는 쿠버네티스에서 지원하는 모니터링, 로깅에 대해서 알아보겠습니다.
쿠버네티스 로깅 및 모니터링
쿠버네티스에서 지원해주는 로깅으로는 애플리케이션의 로그를 볼 수 있는 CLI command인 kubectl logs <리소스 이름>와 모니터링으로는 CPU, MEM 사용량 등 제한된 정보를 볼 수 있는 Metrics Server가 존재합니다. Metrics Server는 기본적인 리소스 메트릭 수집을 담당하는 컴포넌트로 클러스터 및 노드를 셋업했을 때 kube-api server처럼 기본적으로 배포되는 것이 아니라 직접 배포해줘야합니다. 그 이후 kubectl top CLI command를 통해서 CPU, MEM 사용량을 파악할 수 있습니다.
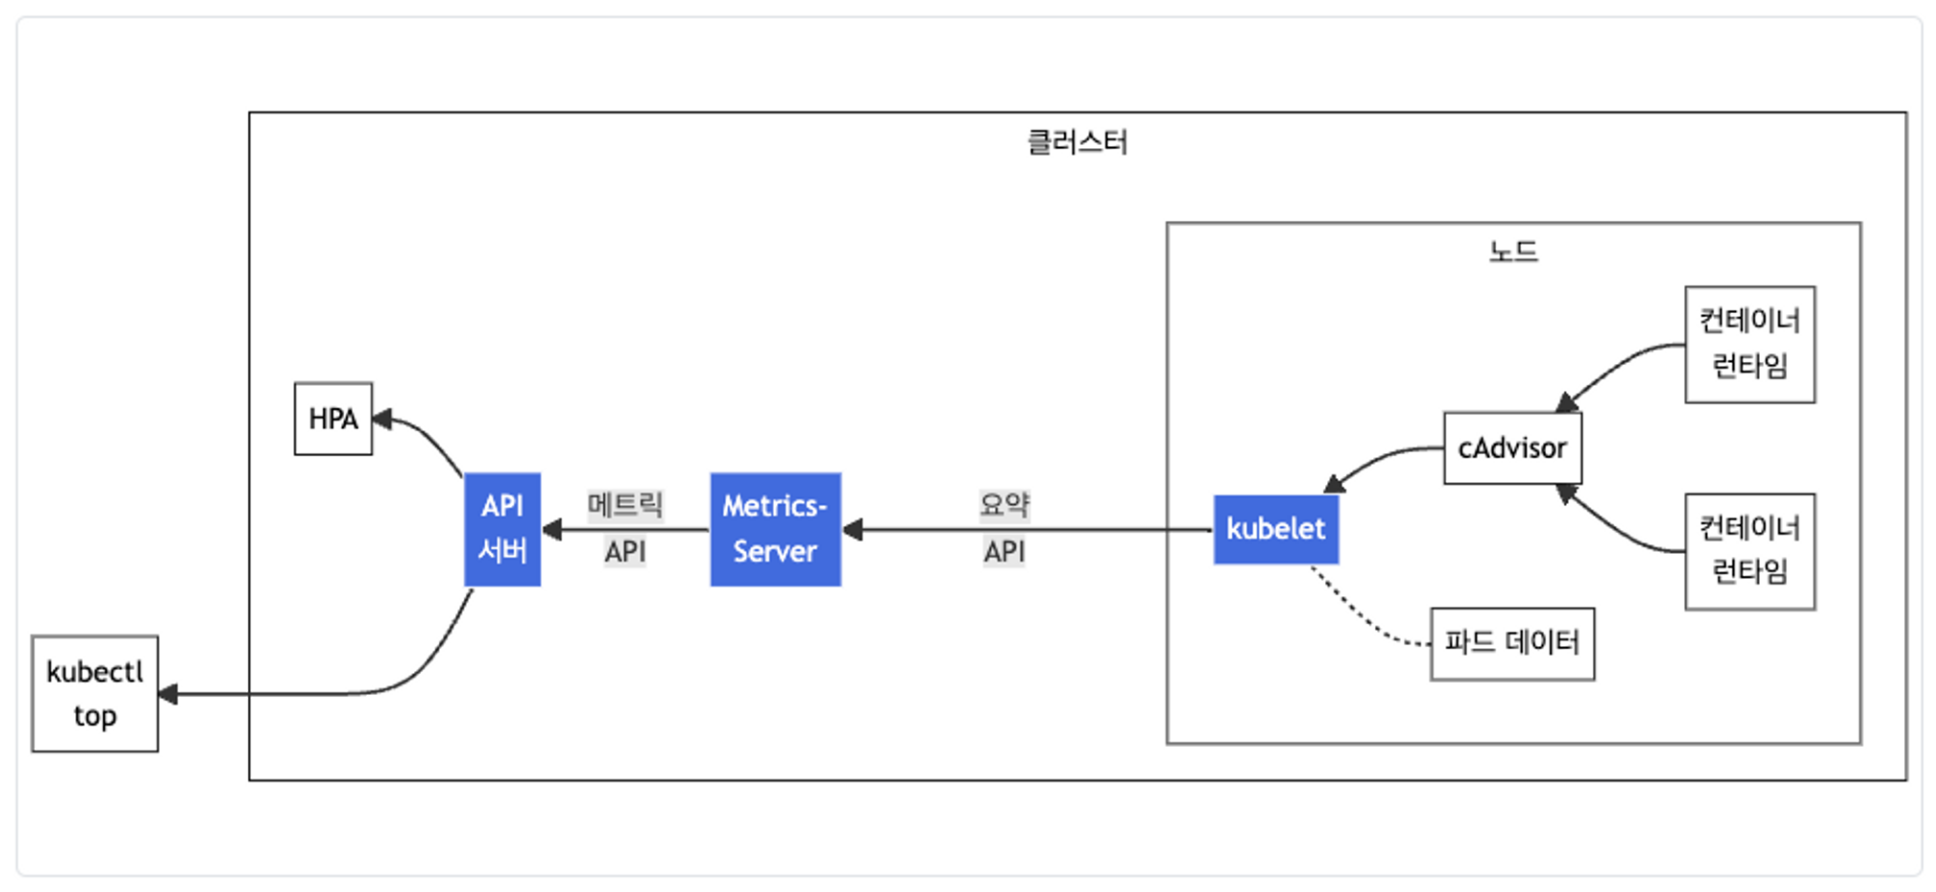 하지만 Metrics Server는 기본적인 메트릭만 제공하여 완전한 메트릭 파이프라인을 구성하고 싶다면 k8s docs에서도 CNCF 프로젝트인 프로메테우스와 같은 모니터링 솔루션을 사용하라고 합니다. 그래서 해당 문서에서는 완전한 메트릭 파이프라인을 구성해보는 시간을 가져보겠습니다.
프로메테우스
프로메테우스는 사운드클라우드에서 구축된 오픈소스 시스템 모니터링 및 알림 툴킷입니다. 메트릭들을 타임스탬프와 함께 저장해서 시간에 따라서 메트릭 모니터링이 가능합니다.
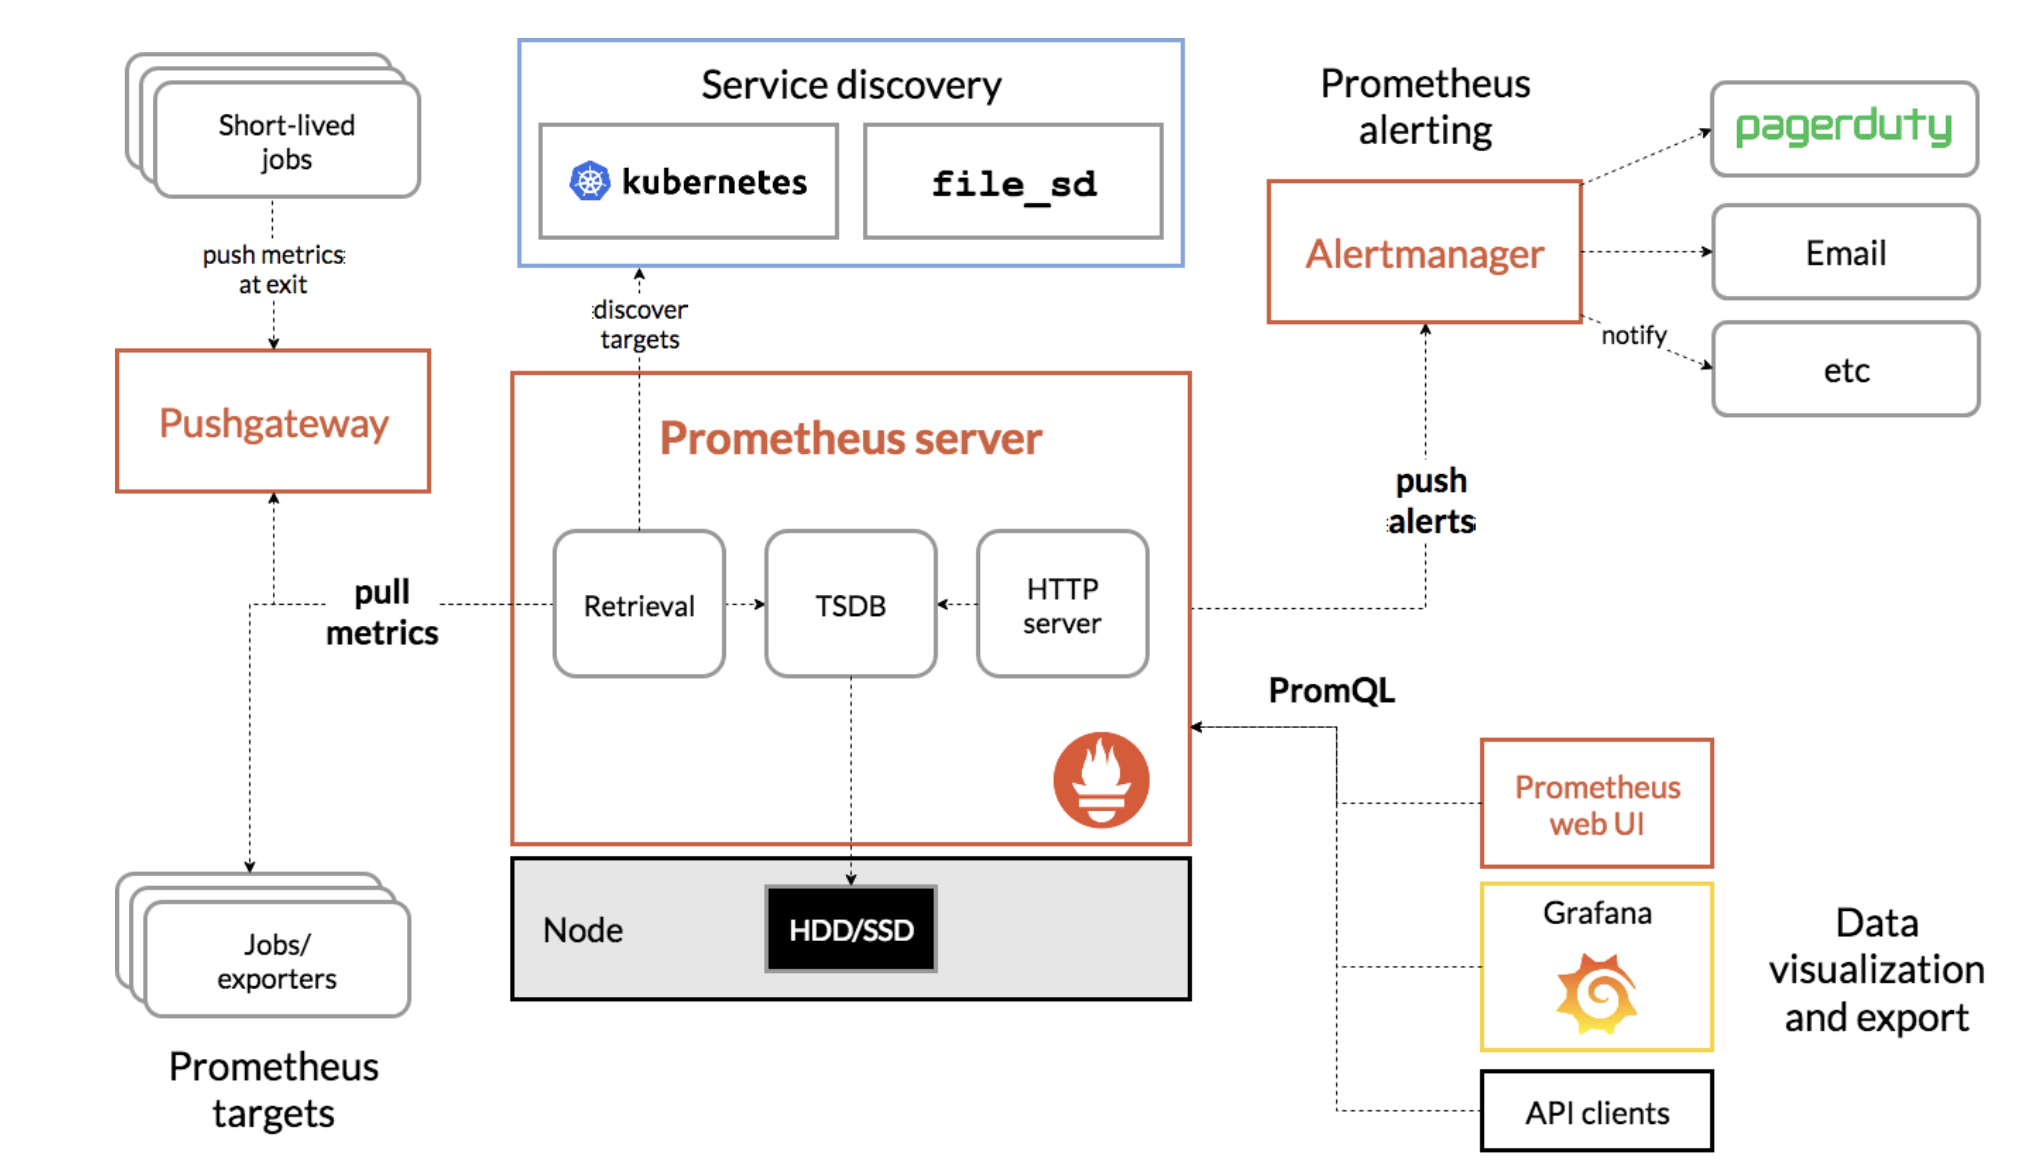
위 아키텍처에서 볼 수 있는 것처럼 job과 같은 라이프 사이클이 짧은 리소스들은 Pushgateway를 이용해서 메트릭을 스크래핑하고 라이프 사이클이 긴 리소스들을 직접 스크래핑합니다. 이 저장된 메트릭을 통해서 Data visualization 해주는 곳에 HTTP Server를 이용해서 출력해주거나 AlertManager를 이용하여 알림을 주는 형태로 동작합니다.
실습
- prometheus, grafana 설치하기 (helm 이용)
# prometheus repo 추가 $ helm repo add prometheus-community https://prometheus-community.github.io/helm-charts # k8s manifests, prometheus rules, grafana dashboard 컴바인된 차트 인스톨 $ helm install [RELEASE_NAME] prometheus-community/kube-prometheus-stack -n [NAMESPACE] # (선택) values.yaml을 가져와서 커스텀하게 수정 $ helm show values prometheus-community/kube-prometheus-stack > values.yaml # grafana port forwarding하면서 띄워보기 $ kubectl port-forward -n [NAMESPACE] svc/prometheus-grafana 3000:80 # 서비스명도 helm install한 릴리즈 네임에 따라 달라짐. - grafana 띄워보기
# grafana port forwarding하면서 띄워보기 $ kubectl port-forward -n [NAMESPACE] svc/prometheus-grafana 3000:80- grafana 대시보드 확인
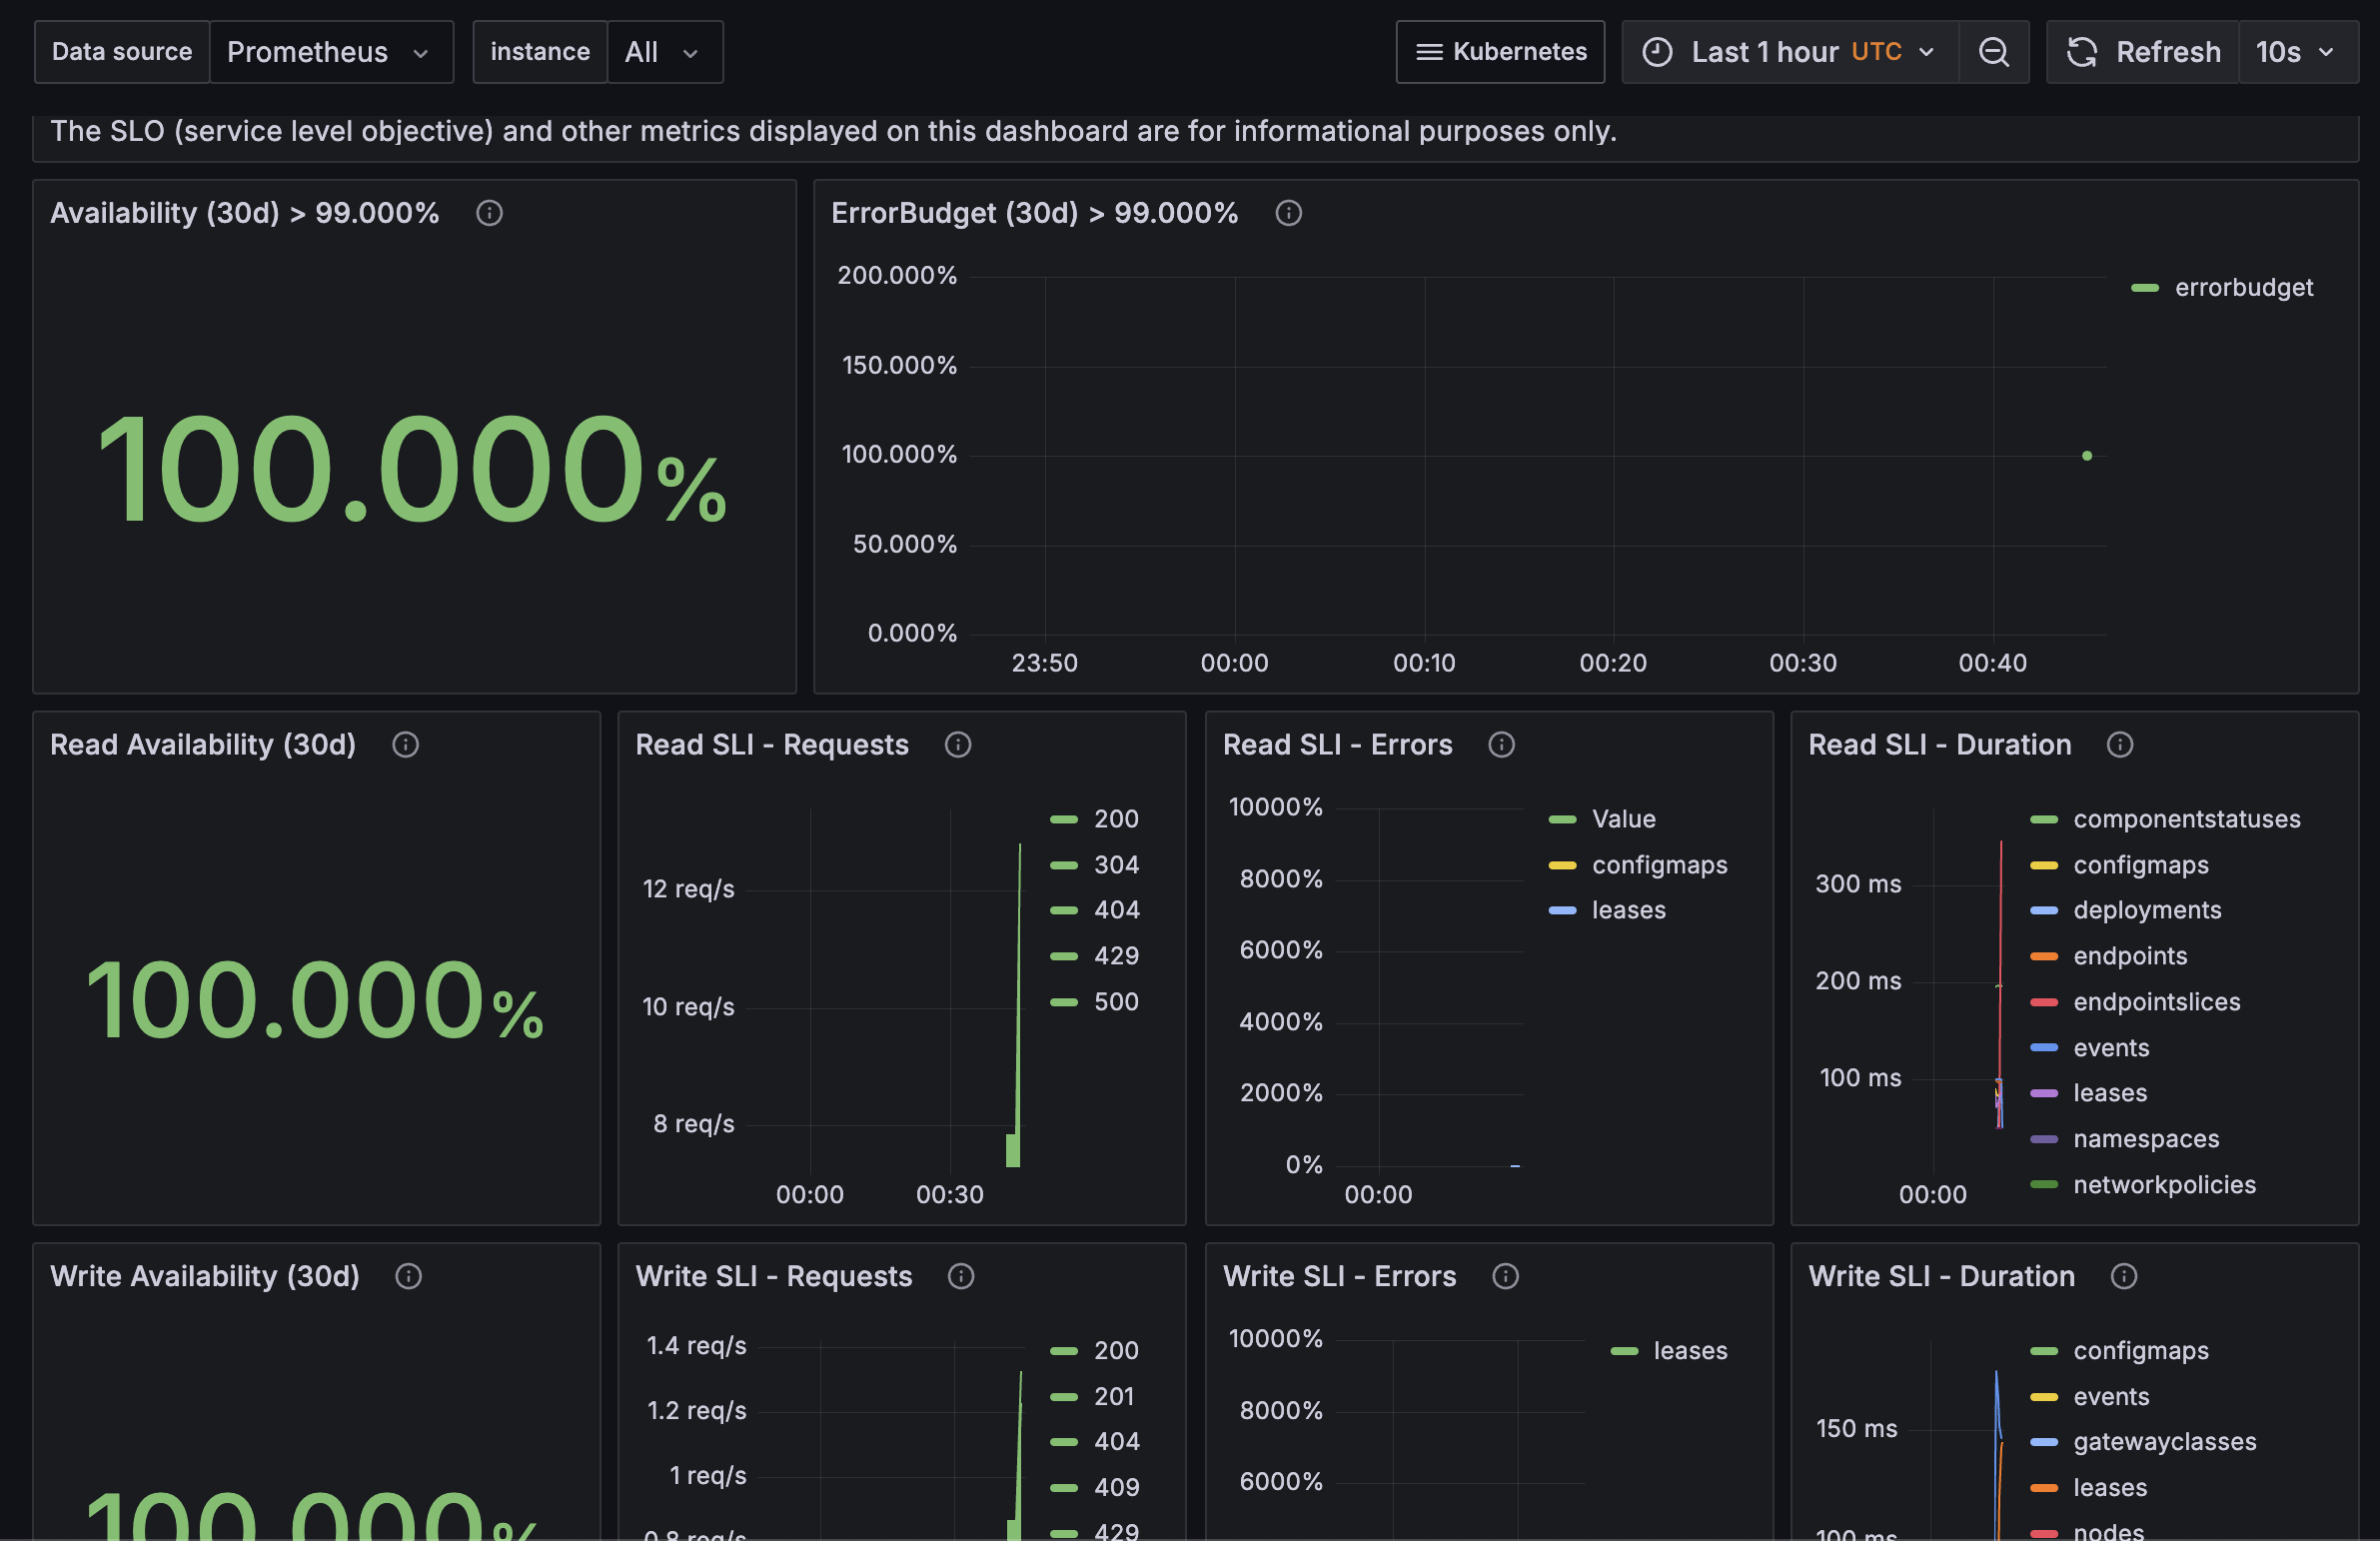
- 리소스 띄워둔게 없어서 확인할 수 있는 메트릭이 API Server 관련 지표 밖에 없어 이를 확인.
- grafana 대시보드 확인
- 추후에 플젝 진행하면서 k8s 관련 메트릭을 어떻게 확인할 수 있는지와 loki를 이용한 로그 모니터링도 업데이트 해보겠습니다.
마무리
이 문서는 과거 학습한 내용을 바탕으로 정리한 것입니다. 잘못된 부분이나 개선할 표현이 있다면 피드백 부탁드립니다.